第三章:8086CPU指令系统
§ 3.1 汇编语言指令
名词解释: 指令:指令就是CPU可以认识的一系列二进制代码,这些二进制代码可以告诉cpu要做什么,如何去做 指令系统:CPU认识的所有认识所有指令的集合就是该型号CPU的指令系统 机器语言:用CPU认识的指令代码(二进制代码)直接编写程序 机器语言程序:用机器语言编写的程序 优点:可以直接执行,缺点:编写相当复杂 汇编语言:符号化语言,把指令用符号和数字来替代 汇编语言源程序:用户用汇编语言编写的程序 汇编:把汇编语言的源程序翻译成机器语言程序的过程 masm.exe 反汇编:把机器源程序翻译成汇编语言源程序的过程
语句的种类: 指令语句:凡是CPU能执行的语句,称为指令语句 伪指令语句:CPU不能执行的语句,叫做伪指令语句 宏指令语句:8086指令系统没有的指令,是用户用宏指令定义伪指令定义的一条新的语句
语句的组成: 语句由四部分组成,名称 助记符 操作数;注释 名称一定要用字母开头
常数及表达式 譬如1,2,3这些数都是常数,因为1就是1,2就是2我们不能改变他,这一类数字类型的量就是数字型常数 譬如'A','B'这种字符也是常数,计算机在定义的时候是把字符转化为ASCII码 譬如5+2+1*2这一类叫做算术表达式这一类表达式在汇编的时候会被汇编器自动计算,算术表达式也可以出现在数据定义伪指令,当然表达式并不只有算术表达式,这里给一张表 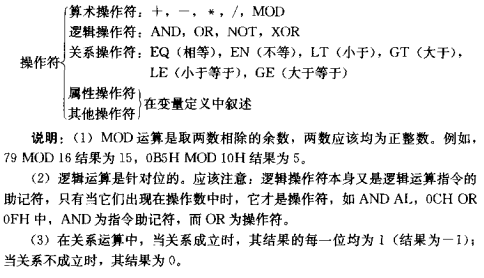
标号
看个例子
nasm
mov ax,0ffffh
next: dec ax
jz next这里的next就是标号,jz next可以在zf为1的时候跳转到next标号,而next标号指向的dec ax就是ax自动减1 标号一旦定义了,就具有了三个属性:
- 该标号对应指令所在存储单元的段地址属性(16位)
- 该标号对应指令所在存储单元的段内偏移地址属性(16位)
- 类型
这三个属性都可以用属性表达式来获取,由于是定义的时候就具有的属性,所以获取到的属性值都是常数,获取段地址用SEG操作符,获取偏移地址用OFFSET,获取标号类型的属性用TYPE
nasm
NEXT:MOV AX,0FFFFH
MOV BX,OFFSET NEXT;获取NEXT标号的偏移地址
对于类型属性有NEAR和FAR两种类型,NEAR型的值是-1,FAR指令的值是-2 NEAR叫做段内转移,表示转移的目的地和源在同一个段,FAR指令叫段间转移,表示转移的目的地和源不在同一个段,但在实际程序设计中,我们认为获取一个标号的TYPE属性是没有任何意义的
变量及变量定义伪指令 变量定义伪指令一共有五种 用DB定义字节数据(1字节)用DW定义字型数据(2字节)用DD定义双字型数据(4字节) 用DQ定义长字型数据(8字节) 用DT定义十字节数据(10字节)
变量定义后,就具有五个属性:
- 段地址属性,用
SEG操作符来获取 - 段内偏移地址属性,用
OFFSET操作符来获取 - 类型的属性(类型的值就是变量所占的字节数),用
TYPE操作符来获取 - 长度属性,用
LENGTH操作符来获取 - 大小属性,用
SIZE操作符来获取
*eg:*在DS段有以下变量定义:
nasm
DAT1 DB 12,12H,-12,'1'
MOV AL,TYPE DAT1;因为DAT1是一个字节型变量,等价于MOV AL,1
MOV BX,OFFSET DAT1;把DAT1的偏移地址传递给BX
我们要获取地址的时候最好是获取到地址寄存器,如果获取到AX中,指令是没有问题的,但是没有任何意义,因为我们获取偏移地址的目的就是为了寻址
那么我们在定义变量的时候,其实是向存储区申请了一块空间,例如我们以上的代码,DAT1 DB 12,12H,-12,'1',就是向存储器申请了四个字节型空间,那他在存储器内是怎么分配的呢? 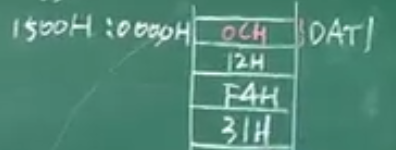
在masm.exe中,有一个$位置计数器(16位),在汇编的过程中始终指向当前汇编的数据或指令所在的存储器单元的偏移地址,我们也可以使用$
例如:
nasm
DAT1 DB 12,12H,-12,'1'
DAT2 DW $;等价于 DAT2 DW 0004H
当我们运行的时候,第二条语句会定义一个字数据,这个字型数据所在的偏移地址是0004H,因为我们前面已经定义了四个字节型数据,所以$的值就是0004H
还有一些其他的变量定义方式需要了解
nasm
DAT1 DB 'THIS';定义了一个字符串
DAT2 DW 'AB','C';读者注意,不论用DW还DD定义字符串,一个字符串只能有两个字符,而DB定义字符串不限字符
DAT3 DW DAT1;这里放的是DAT1变量的偏移地址
DAT4 DD DAT1;这里放的是DAT1变量的偏移地址后再取段地址属性,偏移地址放在低16位,段地址放在高16位
DAT5 DB 4 DUP(0);DUP叫做重复操作符,表示重复定义,这里表示重复定义四个字节型的0
DAT5 DW 3 DUP(?);问号表示保留初值,存储器原来是多少就是多少,是一个随机值,这里表示定义了三个没有初值的字单元
当然dup指令时可以嵌套的,这里给一个例题
*eg:*在缓冲区buf2中,保存5个字节的55H,再保存10个字节的240,并将这一过程重复7次;
nasm
buf2 DB 7 DUP(5 DUP(55H),10 DUP(240))我们前面说了,变量定义具有五个属性,咱么只说了三个,还有长度属性和大小属性,这里说明一下:
长度:变量的长度属性就是在变量定义语句中第一个DUP前面的系数,如果没有DUP,那么就是1
大小:大小属性等于长度属性乘以该变量类型所占的字节数,即SIZE = TYPE * LENGTH
我们说完了属性操作符后,最后还有操作符叫PTR(属性临时修改操作符),这里简单说一下
nasm
DAT1 DB 12,12H
MOV AL,DAT1;这里把12放到了AL,这里用到的寻址方式叫做直接寻址
NOP ;MOV AX,DAT1 如果我们这么写肯定报错,因为DAT1是字节类型,AX是字寄存器,那我们怎么把这个字节型数据变成字型数据呢
MOV AX,WORD PTR DAT1;这就类似于高级语言中的强制类型转换,把PTR在这条语句中临时转换成字单元
执行完后AX的内容就是120CH
再举个栗子
nasm
MOV [BX],10H;当我们要执行这个代码的时候,肯定是报错,因为我们不知道10H是一个什么类型的数据,这个时候就需要用PTR说明
MOV BYTE PTR [BX],10H;这里说明了[BX]找到单元的类型,就会把10H当做字节单元处理
§ 3.2 8086指令分类
指令按照功能分分为13类
- 数据传输类指令
- 算数运算类
- 逻辑运算类
- 移位类指令
- 标志位操作指令
- 转移指令
- 循环控制指令
- 子程序调用和返回指令
- 中断调用返回指令
- 字符串操作指令
- 输入输出指令
- 其他指令
- 宏指令
为了叙述方便,我们有很多缩写,这里一一列出
| 符号 | 英文原文 | 含义 |
|---|---|---|
| OPR | operands | 表示一个操作数 |
| SRC | source | 表示源操作数 |
| DST | destination | 表示目的操作数 |
| REG | register | 表示一个寄存器 |
| REGn | register with n bits | 表示一个n位寄存器 |
| MEM | memory | 表示一个存储单元 |
| CNT | counter | 表示计数值 |
| LABLE | lable | 标号或过程名 |
| PORT8 | port address with 8 bits | 8位端口地址 |
| DISPn | displace with n bits | 表示n位的偏移量 |
| EA | effective address | 表示有效地址,即段内偏移表示段地址 |
| SEG | segment address | 表示段地址 |
| IDATA | im data | 表示立即数 |
| moving | 表示数据传送 | |
| exchange | 表示数据交换 | |
| 表示取的内容 | ||
| and | 逻辑与运算 | |
| or | 逻辑或运算 | |
| xor | 逻辑异或运算 | |
| not | 逻辑非运算,按位取反 |
§ 3.3 数据与转移地址的寻址方式
寻址方式:简单地说,寻址方式就是求操作数所在地或所在的存储器单元地址的方式
我们可以把求得的操作数当做数据,也可以当做转移的地址用,所以寻址方式也分两种
数据的寻址方式(8种)
==立即数寻址== 我们要寻找的操作数在指令中以常数的形式给出
nasmMOV AX,1234H;对于源操作数而言,使我们在程序中直接给出的,采用的就是立即数寻址,立即数只能做源操作数==寄存器寻址== 我们要寻找的操作数在寄存器中
nasmMOV AX,BX;把BX的内容放到AX,这里用的就是寄存器寻址 MOV AX,CL;请注意这条指令是错误的,CL是8位寄存器,AX是16位寄存器,传送的时候要保证两者位数一致 MOV [1234H],12H;这条指令也是错的,因为无法确定这个存储器单元字节的大小,立即数也无法确定是一个几位的数据 MOV WORD PTR [1234H],12H;这样改了之后,指令就正确了 MOV DS,1234H;这条指令也有问题,因为由于8086设计问题,我们无法用立即数给段寄存器赋值,那我们如何给段寄存器赋值呢?可以尝试以下方式 MOV AX,1234H MOV DS,AX;用AX做中介后就可以了,当然我们也只能给DS,SS,ES这三个段寄存器赋值,我们不能直接修改CS和IP的值==存储器寻址== 寻找的操作数在存储器某单元中,存储操作数单元的EA可以由以下五种寻址方式求得
==直接寻址== 在指令中直接写出单元的地址
NASMMOV AX,[1234H];把DS:1234H的字单元数据传送到AX ;在DS段 dat1 DB 12H dat2 DB 34H ;在CS段 MOV AL,dat1;把dat1单元的内容读到AL去,这个寻址方式就是直接寻址 MOV dat2,dat1;这样不行的,两个存储单元之间不能直接操作 MOV AL,dat1 MOV dat2,AL;这样用AL做过度就可以了 ;同样的 MOV dat1,AX;这样也是不允许的,因为我们定义变量的时候把dat1定义为一个字节变量 MOV WORD PTR dat1,AX;这样用PTR临时修改dat1的类型就是允许的,这个时候dat1的内容是AL,dat2的内容是AH==寄存器间接寻址== 用寄存器间接给出单元地址,只能用BX,SI,DI,这里没有把BP归到这里,间接寻址的默认数据段都是DS
nasm;在DS段 dat1 DB 12H dat2 DB 34H ;在CS段 MOV BX,OFFSET dat1;立即数寻址,因为变量的属性是一个常数,把dat1的偏移地址给BX MOV AL,[BX];把DS:BX单元地址的内容放到AL里 MOV [BX],56H;这里是错误的,因为地址单元和立即数都无法确定操作数据的字节大小 MOV WORD PTR [BX],56H;这样就对了 MOV BX,OFFSET dat1 MOV SI,OFFSET dat2 MOV [BX],[SI];这样也是错的,两个存储器单元不能直接操作 MOV AL,[SI] MOV [BX],AL;这样用AL中介就可以了==寄存器相对寻址== 一个寄存器+一个常数,寄存器可以用BX,BP,SI,DI,注意如果用BP,默认段就是SS
nasm;在DS段 dat1 DB 12H dat2 DB 34H ;在CS段 MOV [BP],AL;把AL的内容放到了SS:BP+0中,请读者注意,这叫做寄存器相对寻址,不是寄存器间接寻址 MOV [BX],OFFSET dat1 MOV BYPE PTR [BX]+3,AL;把AL的内容写到[BX]+3内存单元中,[BX]+3等价于[BX+3]等价于3[BX] MOV dat1[BX],AL;这条指令完成的功能是:把AL写入到OFFSET dat1+[BX]所在单元,注意,段地址是dat1所在段的段地址nasmPUSH AX PUSH BX PUSH CX ;在不使用pop的前提下把压入堆栈段的AX读到DX,这种方式可以在不破坏堆栈状态的前提下读取堆栈区的数据 MOV BP,SP MOV DX,4[BP]==基址变址寻址== 一个基址寄存器+一个变址寄存器,BX/BP+SI/DI,如果基址寄存器用的BX默认就在DS,如果基址寄存器用的BP默认就是SS
nasm;在DS段 dat1 DB 12H dat2 DB 34H ;在CS段 MOV BX,OFFSET dat1 MOV SI,0 MOV AL,[BX][SI];此时AL的内容就是12H INC SI MOV AH,[BX][SI];此时AH的内容就是34H==基址变址相对寻址== 一个基址寄存器+一个变址寄存器+一个常数,BX/BP+SI/DI+位移量;如果位移量是常数,就用基址寄存器来确认所在段,如果位移量是变量,就取变量的偏移地址,并且段取变量定义的段
==隐含寻址==
隐藏了操作数,例如PUSH AX,我们并没有给出地址,但CPU知道要把SP-2后把AX写到SS:SP单元中
转移地址的寻址方式
说白了,转移就是改变程序的运行顺序,转移地址的寻址方式分两种,段内转移和段间转移
如果是段内转移,那么只有ip改变了,我们就只需要找到转移目的地的偏移地址即可 段内转移有两种寻址方式: ==段内直接寻址:== 我们以无条件转移指令jmp为例:
NASM
A:NOP
NOP
NOP
NOP
JMP A
NOP
看上面代码的jmp指令,运行第五行的时候会跳转到第一行,这是一个死循环,但是这里需要读者理解jmp指令更深层的原理
对于jmp A而言,如果把他汇编成机器码,jmp指令会占用一个机器码,后面的A标号汇编后也会有一个机器码,大多数读者会认为后面这个A汇编后就是A的偏移地址,但结果却不是这样,执行完第五行后,IP指向第六行,在本程序中jmp指令汇编成机器码后,后面跟的这个数,就是这个A标号基于第六行的偏移地址,也就是-5,所以实际上,我们执行jmp A的时候,本质上并不是让他跳到标号A的地方,本质上是让他跳到前面的第五条指令,如果转移范围在-128~+127,就用一个字节来描述,如果大于这个数,就用两个字节来描述
这里还有一个公式,JMP后面这个标号汇编后的值+下一条指令的偏移地址=标号处的偏移地址
从上面的描述可以得知,jmp指令有可能是双字节指令,有可能是三字节指令,如果转移范围在-128~+127就是双字节指令,如果超过了就是三字节指令,作为程序员,如果我们明确知道这个转移范围不会超过-128~+127,我们还可以把JMP写成JMP SHORT
8086指令系统中所有的条件转移指令都是双字节指令,只能在段内转移.且转移范围为-128~127,如果条件转移超过了这个范围,直接报错,我们可以用无条件转移指令jmp去搭桥实现二级跳,且所有的条件转移指令寻址方式都是段内直接寻址
==段内间接寻址==
nasm
;DS段
TABLE DW A;这里放的是A的偏移地址
;CS段
A:NOP
NOP
MOV BX,OFFSET A
JMP BX;这里把A的偏移地址放在了BX单元
JMP TABLAE;这里把A的偏移地址放在了TABLE单元
MOV BX,OFFSET TABLE
JMP [BX];让BX存储TABLE的偏移地址,通过BX寻址TALBE单元后把TABLE单元内的内容拿出来作为目的操作数,也属于段内间接寻址
我们把A标号的地址放在寄存器或者内存中里,再JMP后面放一个寄存器,就实现了段内间接寻址
§ 3.4 数据传送类指令
除了SAHF和POPF外,其余传送指令CPU执行后对六个状态标志无影响
所有数据传送类指令都要遵循的语法规则:
- 立即数只能做源操作数
- 类型要一致
- 类型要明确
- 不能用立即数给段寄存器赋值
- 不能用数据传送指令给CS,IP赋值
- 两个存储器单元之间不能直接操作
通用数据传送指令MOV
NASM
MOV AX,BX;把BX传送到AX本指令相信读者已经很熟悉了,这里不多赘述
取有效地址指令LEA
nasm
LEA 16位寄存器(一般在BX,BP,SI,DI),存储器单元(5种寻址方式之一的字型单元)
MOV BX,OFFSET dat1
LEA BX,dat1;这两句等价
取地址指针指令(LDS)(LES)(了解)
读者需要了解指针是啥,汇编中的指针是双字类型的数据,第一个字单元存储的是一个偏移地址,第二个字单元存储的是一个段地址,这样一个段地址一个偏移地址就可以指向一个地址,相当于用两个字保存了一个地址,这就是指针
nasm
LDS 16位寄存器,存储器单元(双字型)
;把第一个字单元的内容放到目标操作数的16位寄存器内,把第二个字的内容放到DS中
标志传送指令(LAHF)(SAHF)
LAHF把FLAGS的低八位传到AH中
SAHF把AH传送到FLAGS的低八位
SAHF指令显然影响标志
数据交换指令XCHG
XCHG把两个数据交换,并且两个操作数均不能为立即数和段寄存器
字节转换指令XLAT
这个指令是隐含寻址,不需要任何数据,完成的功能是把DS:[BX+AL]传送到AL
堆栈操作指令(PUSH)(POP)(POSHF)(POPF)
堆栈操作都要按字操作,不能PUSH一个立即数
POPF会影响标志位
§ 3.5 算数运算指令
- 只要CPU执行了运算类指令,运算结果就会影响标志位
- 所有的段寄存器不能参加运算
加法指令
ADD 目的操作数,源操作数 目的操作数+源操作数,然后把结果送到目的操作数 根据结果设置六个状态标志
ADC 目的操作数,源操作数 目的操作数+源操作数+CF,然后把结果送到目的操作数 根据结果设置六个状态标志
自增指令INC 目的操作数 把目的操作数+1再送到目的操作数 根据结果设置除CF以外的五个状态标志,对CF无影响
减法指令
SUB 目的,源 目的操作数-源操作数,结果放到目的操作数 结果影响六个状态标志
SBB 目的,源 目的操作数-源操作数-CF,结果放到目的操作数 结果影响六个状态标志
自减指令DEC 目的操作数 目的操作数-1,结果放到目的操作数 根据结果设置除CF以外的五个状态标志
比较指令:CMP DST,SRC DST-SRC,结果不要,只用来影响标志位 通过判断标志位,就实现了条件分支 JC/JNC JS/JNS JZ(JE)/JNZ(JNE) JP/JNP JO/JNO 这些都是条件转移的指令,请注意AF标志位不能做条件
当然还有一些条件转移指令,这里简单说一下 对于无符号数而言,没有大小之分,只有高低之分 判断两个无符号数相等依旧用ZF,这个不用多说,那如何判断两个无符号数不等呢? 在8086无符号数中,我们用A来表示高于,用B来表示低于,用E来表示等于
NASM
COM AL,BL
JB NEXT;如果AL低于BL,就跳转到NEXT
JNAE NEXT;等效于第二行代码,如果AL不高于且不等于BL就跳转到NEXT
JC NEXT;严格意义上讲,对于无符号数而言,JB和JC是等价的
JBE NEXT;如果AL低于或者等于BL,就跳转到NEXT
JNA NEXT;等价于上一句,如果AL不高于BL,跳转到NEXT
JA NEXT;如果AL高于BL,就跳转到NEXT
JNBE NEXT;与上句等价,如果AL不低于且不等于BL,就跳转到NEXT
JAE NEXT;如果AL高于或者等于BL,就跳转到NEXT
JNB NEXT;如果AL不低于BL,就跳转到NEXT
;对于有符号数而言,我们也来说一下,对于8086有符号数而言,大于用是G,小于用的是L
JZ NEXT;和无符号数一样,有符号数也是通过判断ZF来判断是否相等,这个很好理解
JL NEXT;如果AL小于BL,就跳转到NEXT
JNGE NEXT;等效于第十三行代码,如果AL不大于且不等于BL就跳转到NEXT
;同理:JLE等效于JNG , JG等效于JNLE,JGE等效于JNL
讲完CMP后,我们再看最后一个求负指令
NEG DST 0-DST放到DST,也就是求DST的补码再放到DST
乘法
无符号数乘法:MUL SRC
乘法明显是一个双操作数指令,但这里只需要给出一个操作数,显然,目的操作数是隐含寻址,被隐藏了 乘法分两种情况,一种字乘,一种字节乘,如果给出来的SRC是一个字节,就用AL乘以SRC,结果为16位,放到AX中,如果给出来的SRC是一个字数据,就做字乘,结果为32位,高16位放到DX,低16位放到AX,读者需要注意,因为计算机需要根据SRC的字节大小判断是字运算还是字节运算,所以SRC可以是一个寄存器,或者一个字节大小或者字大小的内存单元,不能为立即数,因为计算机无法判断一个立即数的位数
不管是字节乘法还是字乘法,乘法操作后只影响CF和OF,对于其他标志位的结果无定义,也就是其他标志位的结果没有任何意义,如果CF和OF都为0,说明高8位或者高16位无效,也就是说结果为0,如果CF和OF同时为1,说明高8位或高16位结果有效
带符号数乘法:IMUL SRC 带符号数乘法和无符号数乘法规则一致,只不过运算的时候是作为有符号数运算的 带符号数乘法的时候,也只影响CF和OF,如果CF和OF同时为0也说明高位无效,但请注意,有符号数的无效并不是全0,而是对低位符号的扩展,换句话说,低位为负数,高位全1,低位为正数,高位全0,如果cf和of都是1,那么高位有有效奇
除法指令
无符号除法:DIV SRC
对于无符号数除法而言,和乘法一样,如果SRC为字节数据,就是字节除法,用AX除以SRC,商为字节数据,放在AL,余数也是自己数据,放在AH,如果SRC为字单元,那就是字除法,用DX:AX除以SRC,商放在AX,余数放在DX,和乘法类似
带符号数除法:IDIV SRC
被除数和除数都为正,则商和余数都为正 被除数为正除数为负 ,则商为负,余数为正 被除数为负除数为正,则商为负,余数为负 被除数为负,除数为负,则商为正,余数为负
除法指令运算后对六个状态标志均无定义
符号扩展指令
CBW 无操作数,把AL中的内容扩展到AX,AH中的内容是AL符号位的扩展
CWD 无操作数,把AX中的内容扩展到DX:AX中,DX的内容为AX符号位的扩展
这两个指令不影响标志位
eg:
nasm
;求 Y=a*b+c-18 (abc均为字节型变量)
MOV AL,a
IMUL b
MOV DX,AX
MOV AL,C
CBW
ADD AX,DX
SUB AX,18
BCD调整指令 BCD数运算的时候结果是存在问题的,需要用BCD调整指令进行调整
==BCD调整指令不做要求==
加法BCD调整(对AL调整): 组合:DAA 分离:AAA
NASM
;56+73组合BCD
MOV AL,56H
ADD AL,73H
DAA
;4+8分离BCD
MOV AL,04H
ADD AL,08H
AAA
减法BCD调整(对AL调整):
组合:DAS 分离:AAS
乘法BCD调整(只能按分离BCD运算)(对AX调整):
AAM
除法BCD调整(只能按分离BCD运算)(对AX调整)(先调整后运算):
AAD
§ 3.6 逻辑运算指令
逻辑运算同样属于运算类指令,故
- 只要CPU执行了运算类指令,运算结果就会影响标志位
- 所有的段寄存器不能参加运算
与运算:AND DST,SRC DST按位与SRC,把结果送到DST CPU执行与运算后CF OF清零 AF无定义 正常设置SF ZF PF
或运算:OR DST,SRC DST按位或SRC,把结果送到DST CPU执行或运算后CF OF清零 AF无定义 正常设置SF ZF PF
异或运算:XOR DST,SRC DST按位异或SRC,把结果送到DST CPU执行异或运算后CF OF清零 AF无定义 正常设置SF ZF PF
测试指令:TEST DST,SRC DST按位与SRC,结果不要了,只影响标志位 CPU执行TEST后CF OF清零 AF无定义 正常设置SF ZF PF
非运算 :NOT DST 目的按位取反后结果送回目的 ==非运算对六个状态标志均无影响==
与运算,或运算,异或运算的用途在§ 1.2 已经说的很清楚了,这就不赘述了
test主要用途是测试某些位是不是位0
§ 3.7 移位指令
移位指令
逻辑移位(无符号数): 逻辑左移: SHL DST,CNT 把DST左移CNT次,当CNT=1是,可以直接给出,当CNT大于1时,要用CL给出 逻辑右移: SHR DST,CNT 把DST右移CNT次,当CNT=1是,可以直接给出,当CNT大于1时,要用CL给出 执行后CF无定义,正常影响其他标志位,其中OF标志位如果移位前后最高位发生变化则自动置1
算术移位(有符号数): 算术左移:SAL DST,CNT 把DST左移CNT次,当CNT=1是,可以直接给出,当CNT大于1时,要用CL给出 算术右移:SAR DST,CNT 把DST左移CNT次,当CNT=1是,可以直接给出,当CNT大于1时,要用CL给出 在执行算术移位的时候,算术左移和逻辑左移是一样的,但是算术右移的时候符号位移到次高位之后符号位不会发生改变 执行后CF无定义
移位运算指令的处理速度相当快
循环移位
不带CF的移位 左移:ROL DST,CNT 把DST左移CNT次,当CNT=1是,可以直接给出,当CNT大于1时,要用CL给出 右移:ROR DST,CNT 把DST右移CNT次,当CNT=1是,可以直接给出,当CNT大于1时,要用CL给出
带CF的移位(把CF作为最高位) 左移:RCL DST,CNT 把DST左移CNT次,当CNT=1是,可以直接给出,当CNT大于1时,要用CL给出 右移:RCR DST,CNT 把DST右移CNT次,当CNT=1是,可以直接给出,当CNT大于1时,要用CL给出
只影响OF和CF,对剩余的标志位无定义
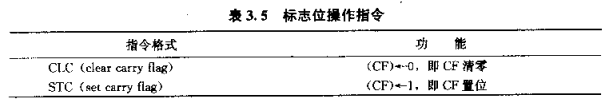
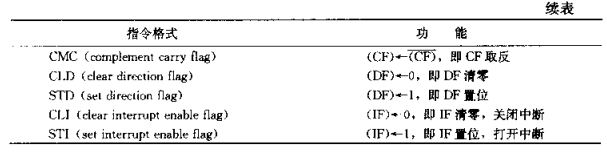
§ 3.8 标志位操作指令
§ 3.9 转移指令
转移指令分两个大类,无条件转移指令和条件转移指令
无条件转移指令
无条件转移主要就是JMP,在[§ 3.3](#§ 3.3 数据与转移地址的寻址方式)那块儿已经说过了,JMP指令从寻址方式分为段内转移和段间转移,其中段内转移分为段内直接寻址和段内间接寻址,这个在前面已经说完了,下面介绍JMP指令的段间转移
nasm
;代码段1
JMP ABC;由于是两个不同的段,所以这样是错的
JMP FAR PTR ABC;必须用FAR来指定远转移,汇编后是五个字节的代码,第一个字节存放操作码,第二三个字节存放ABC的偏移地址,第四五个字节存放ABC的段地址,这里是直接给出ABC标号的,所以属于段间直接寻址
;代码段2
ABC:NOP
nasm
;在DS段
TABLE DD ABC;第一个字单元放的ABC的偏移地址,第二个字单元放的ABC的段地址,也就说,TABLE变量存放的是地址指针
;代码1段
ABC:NOP
;代码2段
JMP TABLE;这是第一种最简单的方法
LEA BX,TABLE
JMP DWORD PTR [BX];这种方法同样可行
条件转移
条件转移指令在前面也介绍过,这里主要注意一下条件转移指令只能实现段内转移,并且都是段内直接寻址 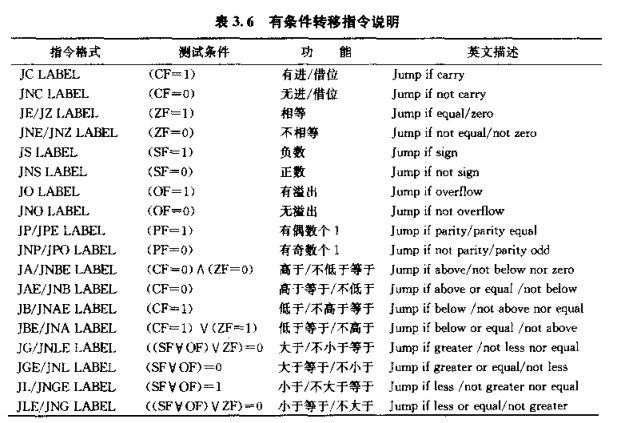
§ 3.10 循环控制指令
LOOP指令
LOOP 标号;
CPU执行LOOP指令完成的功能
- SUB CX,1;注:不影响标志位
- 若(CX),则跳转到标号
因为是先减一后判断,所以当CX为0的时候,循环次数最大,为65536
一个标准的循环程序的结构:
nasm
;初始化
MOV CX,循环次数
;循环工作体
L1:

;参数修正

;循环控制
LOOP L1
;结果处理

;程序结束
LOOPZ指令(等效于LOOPE)
LOOPZ 标号
执行LOOPZ的过程
- SUB CX,1;不影响标志位
- 如果(CX),且ZF=1则转移到标号
这种指令非常适合于在指定区域中查找不同的“字符”,当找到不同的“字符”时,会自动退出循环。
举个例子
nasm
;数据段
STRING DB '111112111';定义了多个字符
COUNT EQU $-STRING;EQU为赋值语句,COUNT是一个符号常量,并没有占用存储器的地址,所以不需要分配地址,将$-STRING的值赋值给COUNT,其中$-STRING就是上一个字符串的长度
;代码段
MOV CX,COUNT
MOV SI,-1
L2:
INC SI
CMP STRING[SI]
LOOPZ L2
JZ L3;如果执行后ZF等于1,肯定没找到
;没有跳转肯定找到了,位移量存储在SI


L3:
$是汇编计数器的当前计数值,在§ 3.1讲过
LOOPNZ指令(等效于LOOPNE)
LOOPNZ 标号
- SUB CX,1;不影响标志位
- 若(CX)且ZF=0,跳转到标号
与LOOPZ相反,适合于在字符串中找相同的字符
JCXZ指令
JCXZ 标号
执行这条指令时,若CX值为0,则跳转,与LOOP指令正好相反,主要用来判断循环指令内CX是否为0,若循环指令第一次就是0,则会做65536次无意义的循环
§ 3.11 子程序调用及返回
子程序的概念:类似于c语言的函数,把程序中需要经常完成的功能定义为一个子程序然后用子程序调用指令去调用
子程序也称为过程
子程序定义: 子程序名 PROC[类型] ;过程体 RET 子程序名 ENDP
如果定义的子程序和调用他的程序在同一个代码段,就用NEAR类型,可以缺省,如果调用的子程序和调用他的不在同一个段,则类型不能缺省,必须写上FAR
过程名,一旦被定义,就具有了三个属性 和标号名属性一样
- 段地址属性(过程中第一条指令的地址)
- 段内偏移地址属性(过程中第一条指令的地址)
- 类型
子程序调用和返回:
nasm
CODE SEGMENT
START :

CALL SUB1


MOV AX,4C00H
INT 21
SUB1 PROC

RET
SUB1 ENDP
CODE ENDS

END START
执行CALL指令的时候,先把IP压入栈内存然后跳转到标号处,执行RET的时候再把栈内存出栈
在进行段间转移的时候,先把ip压入,再把CS压入,返回时先返回CS,再返回IP
在调用后,第一时间把要用的寄存器放在栈内存保护起来,返回之前我们再从栈内存返回出来
参数传递,可以采用寄存器传递,也可以用内存空间传递或者用栈内存传递
子程序说明文件 属于注释,所以前面都要有分号,有以下内容
- 子程序名
- 子程序功能
- 入口参数
- 出口参数
- 用到的寄存器/用到的存储单元
- 举例(略)
子程序允许嵌套与递归
子程序内部可以调用其他子程序,每次调用的时候都要push进堆栈一个ip,所以要注意堆栈的大小,多级嵌套也不利于程序调试
子程序可以调用自己,在递归子程序设计的时候要注意出口条件,否则就是死循环,由于递归子程序的程序复杂度高,所以在程序设计的时候要避免出现
在ret语句返回的时候,我们一定要保证堆栈指针sp指向原来的位置,如果我们保证不了,我们就要在ret语句后面加上一个参数,ret后面跟几,程序返回的时候就会把sp加几
本节包含了§ 4.5的所有内容
§ 3.12 中断调用与返回指令
CPU在执行程序的时候,由于一些原因导致了CPU暂停执行,去为中断服务子程序服务,最后要中断返回
对CPU发起中断请求的程序叫做中断源,中断源可以在CPU内部,也可在CPU外部,内部提起中断的叫做内部中断,外部提起的中断叫做外部中断 对于外部中断而言,又两个引脚可以提出中断, 通过提出的中断请求叫做外部非可屏蔽中断请求,CPU要无条件响应,而通过引脚叫做外部可屏蔽中断请求,CPU是否响应根据IF状态标志来控制,如果IF为1,则响应,的中断类型码为8~255,的中断类型码为2 对于内部中断而言,CPU必须响应
内部中断5种类型:
- 除法错中断源:执行除法指令时,如果除数为0,或者商溢出,则产生内部中断,中断类型码为0
- 单步中断源:TF为1时没执行一条指令都会产生一个中断,中断类型码为1
- INTO指令:执行INTO指令后,判断OF的值,如果OF为1则执行中断服务子程序,否则继续执行,中断类型码为4
- 断点中断:本中断是由INT 3指令导致的,主要是为了进行DEBUG调试程序,查看运行结果是否正确,INT 3指令汇编后的机器码为3CH,为单字节指令,所以有的教科书也称为单字节中断,中断类型码为3
- INT N中断:INT后面跟哪个中断类型码,就执行哪种类型的中断,INT 3实际上是执行三号中断,INT 21H实际上是执行21H号指令,INT 21H执行的是DOS功能调用,由于DOS系统完成各种功能的子程序很多,所以给AH一个功能号,来确定调用的哪一个DOS系统子程序
CPU只有能识别中断请求的来源,才能跳转到对应的中断服务子程序入口,为了识别中断源,CPU给每一个中断源都编了一个中断类型号,从0~255一共256个,所以CPU一共可以管理256个中断
除法错中断:0号
单步中断:1号
断点中断:3号
INTO中断:4号
INT N中断:N
对于外部中断而言,有NMI和INTR两条请求引脚
通过NMI请求的叫做外部不可屏蔽中断请求,中断类型号是2,这个引脚是上升沿有效,换句话说,如果对NMI加一个上升沿,CPU就必须要响应这个请求,不受IF控制,叫做外部非可屏蔽中断请求
通过INTR引脚发出的中断请求叫做外部可屏蔽中断请求,高电平有效,通过这个引脚对CPU提出的中断请求受IF控制,只有IF为1,CPU才响应中断,通过INTR发出的中断请求,中断类型号是由用户确定的,用户需要在CPU外部扩充中断控制器(8259A)来管理外部可屏蔽中断
一片8259A有8个输入请求端,分别从~,任何一个输入端都可以外接一个中断源,任何一个中断源都可以通过这八个输入端之一向8259A提出中断请求,然后由8259A的INT输出端向CPU的INTR引脚输出,8259作为一个IO设备,有8根数据引脚,~,可以把他和CPU的第八位数据线连起来,我们可以用OUT指令8259的命令寄存器写不同的命令来改变8259工作方式,如我们可以给8259初始化类型号,命令的类型号为08h,那么后面的类型号自然就确定了,自然就成了09h,就是0ah,所以我们在初始化的时候只需要初始化IR_{0}的中断类型码
中断向量
CPU执行指令的时候,遇到中断后,要响应中断,响应中断的地方我们叫做中断现场,响应中断之前肯定要把现场保存起来,也就是压入栈(把PSW,CS,IP依次压入栈),例如CS IP PSW这些信息,否则就回不来了,那么响应中断的时候CPU肯定是要知道中断子程序的入口地址的,否则他就不知道他中断下来干嘛,那么这里的中断向量就是中断子程序的入口地址,是32位(4字节)的,包含16位段地址和16位偏移地址
中断向量表
上面说了中断向量,那么CPU去哪里找这些中断向量呢?CPU去中断向量表里找中断向量,中断向量表就在内存中,8086一共能寻址1m个字节单元,把其中的前1024个字节单元用来作为中断向量表,也就是00000H~003FFH,00000H~00004H存放的是0号中断的入口地址,00005H~00008H存放的是1号中断的中断向量,依次类推下去,1K字节的中断向量,每个中断向占4个字节,一共就是256个中断向量,也就明白了为什么8086只能管理256个中断 我们前面有一个INT 21H中断,中断类型码为21H,那这个中断的入口地址在哪呢?很显然,如果我们一个一个数下去不显示,我们就找一个关系,一个中断向量占4个字节,所以我们用中断类型码乘以4,就得到了该中断类型码的中断向量的地址,所以当我们要调用第N号中断的时候,我们就要把中断子程序的入口地址放到N*4单元去,其中偏移地址放到N*4单元,段地址放到N*4+2单元,我们把中断子程序的入口地址写到中断向量表的过程叫做中断向量的建立,所以当CPU执行21H的时候,实际上就是从84H单元取一个字给IP,再从86H取一个字给CS,让CS:IP指向中断服务子程序的入口,然后继续执行,当然,当CPU执行中断的时候,肯定是会结束的,不可能一直执行下去,CPU在中断子程序内部执行IRET指令,就会恢复现场,也就是把执行中断子程序前保护的现场恢复过来(弹出一个字给IP,弹出一个字给CS,弹出一个字给PSW)
如果在中断服务子程序内用到了某些寄存器或者内存单元,但是用这些内存器和单元和主程序有冲突,换句话说主程序中用到的寄存器或内存单元在中断子程序还要用,那么就要用栈内存把这些内存单元保护起来,在IRET结束之前要出栈恢复,这一点和子程序设计是一样的
中断响应过程
- 保护现场
- IF和TF清零 IF清零后就不会响应外部可屏蔽中断了,如果我们还需要CPU在执行中断服务子程序的时候也响应可屏蔽中断,那么我们就要用STI指令让IF置1
- 把中断类型号乘以4得到一个地址,找到这个地址的单元,取一个字给IP,在N乘以4加2单元取一个字给CS,让CS:IP指向中断服务子程序的入口地址
- 转到中断服务子程序中执行
- 执行结束,恢复现场
以上是响应非可屏蔽中断请求的过程,如果是可屏蔽中断请求,CPU会先判断IF是否为1,只有IF为1时,才响应可屏蔽中断,并且外部可屏蔽中断的中断类型号是外部给出的,所以在执行第三步之前还要去向8259A获取中断类型号
给出可屏蔽中断的中断过程
- 如果IF为1,响应中断
- 保护现场
- IF和TF清零
- 告诉8259A可以响应中断请求 通过引脚向8259的发送一个负脉冲
- 从8259A获取中断类型码 通过发送第二个负脉冲,当8259A收到第二个负脉冲的时候,就把存放中断类型号的寄存器的值通过数数据线传给CPU了
- 把中断类型号乘以4得到一个地址,找到这个地址的单元,取一个字给IP,在N乘以4加2单元取一个字给CS,让CS:IP指向中断服务子程序的入口地址
- 转到中断服务子程序中执行
- 执行结束,恢复现场
我们可以把8259的一个输入引脚脸上另一个8259的INT输出端形成一个级连,这样就可以管理更多的外部可屏蔽中断,每一个引脚都可以借上一个新的8259,其中直接连接CPU的8259叫做主片,其余的叫做从片,由于8259只有八根输入端,所以最多能连上8个8259,最多也只有9片(8个从片+1个主片)8259级连工作,能管理64级可屏蔽中断 假如外部有4片8259级联工作,那么四片8259级联工作一共能管理29级可屏蔽中断(4片*8根输入端-(4片-1个主片)) 普遍一点:n片8259级联工作一共可以管理(n*8-(n-1))级可屏蔽中断
系统功能调用
这里的系统包括DOS操作系统,和BIOS系统 调用DOS系统的时候叫做高级功能调用,调用BIOS叫做低级功能调用 实际程序设计中,我们调用功能的时候需要去查响应的功能调用表 调用DOS系统功能的时候,使用INT 21指令
这里只说常用的功能
01H号 功能:等待用户从键盘输入一个字符,并回显(把输入的字符显示在屏幕上) 入口参数:AH=01H 出口参数:AL保存读取到字符的ASCII码
nasmAGAIN:MOV AH,01H INT 21H ;等待用户按键盘 CMP AL,'1' JB AGAIN;JB:无符号数低于 CMP AL,'5' JG AGAIN;JG:有符号数的大于,也可以用JA,也就是无符号数的大于 ;本程序完成的功能为等待用户输入一个'1'~'5'之间的字符07H号/08H号 功能:无回显的输入 入口参数:AH=07H/AH=08H 出口参数:AL保存读取到字符的ASCII码 07号不检测Ctrl z,08号检测Ctrl z
02H号 功能:向屏幕输出一个字符 入口参数:AH=02H DL=要输出字符的ASCII码 出口参数:无
nasmMOV AH,2 MOV DL,0DH INT 21H ;输出一个回车字符05H号 功能:向打印机输出一个字符 入口参数:AH=05H DL=待打印字符的ASCII码
常用ASCII码 空格:32 20H 回车:13 0DH 换行:10 0AH 'a' 97 'A' 65 '0' 48
06H号 功能:输入或输出一个字符(不等待,需要循环一直判断)
入口参数: AH=06H 若DL=0FFH,则输入一个字符 若DL=00H~0FEH,则对应ASCII码的字符 出口参数: 输入后的字符的ASCII码读到AL中
如果在执行过程中没有按键,那么ZF置1
09H号 功能:向显示器输出一串字符 入口参数:AH=09H DS:DX指向字符串的首地址
结束符为'$',当09号中断读到'$'后,自动结束
0AH号 功能:从键盘读入一串字符串 入口参数:AH=0AH DS:DX指向输入缓冲区 需要事先在数据段定义键盘输入缓冲区
§ 3.13 字符串操作指令
为了简化字符串操作,提出了字符串操作指令
一共有五种字符串操作指令
- 字符串传送指令MOVSB(按字节传送)/MOSW(字传送)
- 字符串比较指令CMPSB/SMPSW
- 串扫描指令/串搜索指令SCASB/SCASW
- 串装入指令LODSB/LODSW
- 字符串存储指令STOSB/STOSW
特点
- 源和目的串均为隐含寻址 如果源串在存储器中,则存储器的地址由DS:SI提供,源串如果在寄存器中,那么一定在AL或AX中 如果目标串在存储器中,则存储器的地址必须有ES:DI提供,在寄存器的话一定在AL或AX中
- 执行串操作的时候SI和DI会自动改变,改变方向受DF控制,DF为0,SIDI自增,如果DF为1,SIDI自减,增减1还是2受操作类型控制
- 串操作指令的左边可以增加重复前缀 REP等效于LOOP REPZ等效于LOOPZ REPNZ等效于LOOPNZ
字符串传送指令:MOVS MOVSB MOVSW MOVS DST,SRC
MOVS不同与MOVS和MOVSB,需要手动指出源和目的
执行REP:MOVSB的过程
- 把DS:SI的字节单元内容传送到ES:DI
- SI和DI根据DF自动增减
- CX-1,如果CX不等于0,跳到第一步
将存储区BUF1中一百个字节数据按次序传送到BUF2
nasm
DATA SEGMENT
BUF1 DB 100 DUP(?)
BUF2 DB 100 DUP(?)
DATA ENDS
CODE SEGMENT
ASSUME CS:CODE,DS:DATA,ES:DATA
START:MOV AX,DATA
MOV DS,AX
MOV ES,AX
LEA SI,BUF1
MOV DI,OFFSET BUF2
CLD
MOV CX,100
REP MOVSB
MOV AH,4CH
INT 21H
CODE ENDS
END START
但是这里还需要考虑一种情况,那就是源串和目标串重叠的情况,这个时候我们就需要反向传送,我们先比较源串和目的串的首地址谁高谁低,如果源串比目的串的值要高,那么按照增加方向传送,如果源串比目的串地址低,就按照减少的方向传送,总之,一定是由目的串到源串的方向
字符串比较指令: CMPSB CMPSW CMPS DST,SRC
第三种书写格式就是用SRC-DST 如果是前两种,就是用DS:SI - ES:DI
减下来的差设置六个状态标志
如果ZF置1,说明他们相等
执行完本指令后,SI和DI的内容会自动增减2,受DF控制
如果加上前缀REPZ,那么就相当于LOOP,让CX-1之后判断CX是否为0,如果CX不为0,且ZF=1,那么就重复执行
字符串扫描指令
SCASB
SCASW
SCAS DST
执行这些指令的时候,先用源减去目的 也就是用AL-ES:DI设置六个状态标志 DI内容自动增减 可以带上REPNZ前缀
CX-1后判断那CX.如果不为0,且zf为0,重复执行
字符串装入指令 LODSB LODSW
把DS:SI的内容放到AL或者AX SI自动增加或减少1或2
字符串存储指令 STOSW STOSB 把AL或者AX存储到ES:DI DI自动增减1或2
§ 3.14 IO输入输出指令
输入指令:
IN DST,SRC
SRC为一个端口地址
IO端口的地址范围:0~65535,由地址线的低16根给IO分配地址,其中,如果地址在0到255,可以直接给出,也可以用DX给出,但如果超过了255,就必须要用DX给出端口地址
IO地址为8位,任意相邻的两个IO地址可以组成一个字端口,如果是字节端口,DST用AL,如果是字端口,DST用AX
输出指令 OUT DST,SRC
和IN指令相反,DST为一个IO端口地址,具体要求和IN指令一样
SRC为AL或AX,用哪个取决于这是一个字端口还是字节端口
CPU执行IN和OUT需要5个时钟周期,而一般的指令只需要4个时钟周期 一般来说,一个总线周期包含了四个时钟周期,而IN或者OUT指令的一个总线周期包含了五个时钟周期
在操作IO前,我们先要找到IO地址,为了找到IO地址,我们要设计IO地址译码电路,用16个地址信号通过逻辑门选择出一个地址,再用M/IO信号判断操作是否对IO进行,再用RD和WR信号判断是读还是写,三个信号相或,得到IO端口芯片的选通信号,或片选信号,注意:控制信号也要参加译码
§ 3.15 其他指令
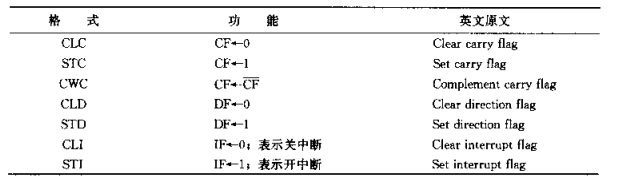
空指令NOP
NOP指令什么也不做,但要占用3个时钟周期的时间,利用NOP指令可以设计延时程序
nasm
MOV BX,时间长度1
L2:MOV CX,时间长度2
L1:NOP
LOOP L1;每循环一次花费了7个时钟周期
DEC BX
JNZ L2;这样就可以实现时间长度1乘以时间长度2的延迟
HLT指令
暂停指令,执行HLT就暂停指令,可以通过请求中断来退出HLT
§ 3.16 宏指令
宏指令的定义:宏指令是用MACRO伪指令定义的
宏名 MACRO [形参1,形参2...]
编写一段完成特定功能的程序,称为宏体
ENDM;不需要在左边写宏名
根据宏指令的功能来确定是否有形参
宏指令和子程序类似,使用宏指令,缺点是浪费空间,但他很省时间,子程序相反