正则表达式是一个全新的知识,内容非常多,也很重要。正则表达式是一个完全独立于 JS 的知识点,是跨语言的,也就是说正则表达式这个东西学会了之后在哪儿都能用,包括其他编程语言,哪怕在一些文本编辑器里也支持正则表达式,比如 sublime 的搜索。
首先,正则表达式是一种专门用于字符串匹配的规则,说简单点,正则表达式就是一些规则,这些规则专门用于匹配字符串,可以用来判断字符串是否满足这些规则,也可以把字符串中满足这些规则的子串给提取出来。实际上读者可以把正则表达式理解为文档的搜索功能,当我们要对一篇文档进行搜索的时候,一般是 ctrl+f,然后直接输入文字,正则表达式就是把这个搜索功能进行了强化。
正则表达式基础
正则表达式是写在两个 / 之间的一串字符串,例如 /abc/ 这就是一个正则表达式。
首先是最简单的字面量匹配,字面量匹配非常简单,就是直接书写字面量,表示这个字符串中必须出现我指定的字面量,例如上面的 /abc/ 表示我这个字符串里必须出现 abc 这个字符串,我们可以参考下面的例子
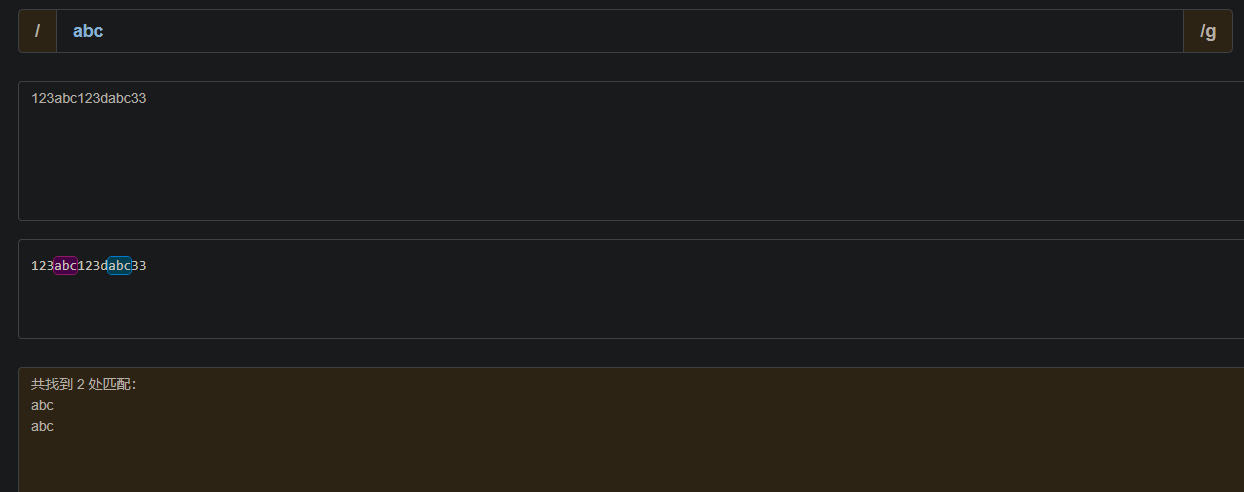
在这个例子中,匹配规则为 /abc/,表示我字符串中必须出现字符串 abc,这里我给出的字符串是 123abc123dabc33,很显然,在这个字符串中,有两个 abc,所以就显示出现两处匹配,从这里读者应该能感知到,正则表达式不仅可以用于判断字符串是否满足指定条件,也可以在一个字符串中把某些满足指定条件的子串给找出来。
上面的字面量我们是直接写字符,这样就可以匹配指定的字符串,就完全类似于我们平时使用的搜索,那比如我这里有这样一个需求,我要匹配到 a*c 的字符串,这个 * 可以是任何字符,就是说不管是 abc,还是 acc,这些,都可以满足条件给他匹配出来。这样的需求正则表达式也可以满足,这里就要用到正则表达式中的特殊字符,以下做一些罗列,以供后面学习作参考。
| 特别字符 | 描述 |
|---|---|
| $ | 匹配输入字符串的结尾位置。如果设置了 RegExp 对象的 Multiline 属性,则 $ 也匹配 '\n' 或 '\r'。要匹配 $ 字符本身,请使用 \$。 |
| ( ) | 标记一个子表达式的开始和结束位置。子表达式可以获取供以后使用。要匹配这些字符,请使用 $ 和 $。 |
| * | 匹配前面的子表达式零次或多次。要匹配 * 字符,请使用 \*。 |
| + | 匹配前面的子表达式一次或多次。要匹配 + 字符,请使用 \+。 |
| . | 匹配除换行符 \n 之外的任何单字符。要匹配 . ,请使用 \. 。 |
| [ | 标记一个中括号表达式的开始。要匹配 [,请使用 \[。 |
| ? | 匹配前面的子表达式零次或一次,或指明一个非贪婪限定符。要匹配 ? 字符,请使用 \?。 |
| | | 将下一个字符标记为或特殊字符、或原义字符、或向后引用、或八进制转义符。例如, 'n' 匹配字符 'n'。'\n' 匹配换行符。序列 '\\' 匹配 "\",而 '\(' 则匹配 " ("。 |
| ^ | 匹配输入字符串的开始位置,除非在方括号表达式中使用,当该符号在方括号表达式中使用时,表示不接受该方括号表达式中的字符集合。要匹配 ^ 字符本身,请使用 \^。 |
| { | 标记限定符表达式的开始。要匹配 {,请使用 \{。 |
| | | 指明两项之间的一个选择。要匹配 |,请使用 \\。 |
我们这里举个例子,就是上面的 .,这个 . 就可以表示换行符之外的任何字符,比如我这个正则表达式 /a..d/ 就表示我要匹配的内容,只要 a 和 d 中间夹的是两个除了换行之外的字符,就满足条件,比如 abcd 就满足条件,acbd 也满足条件,azzd 也满足条件,就这么简单。
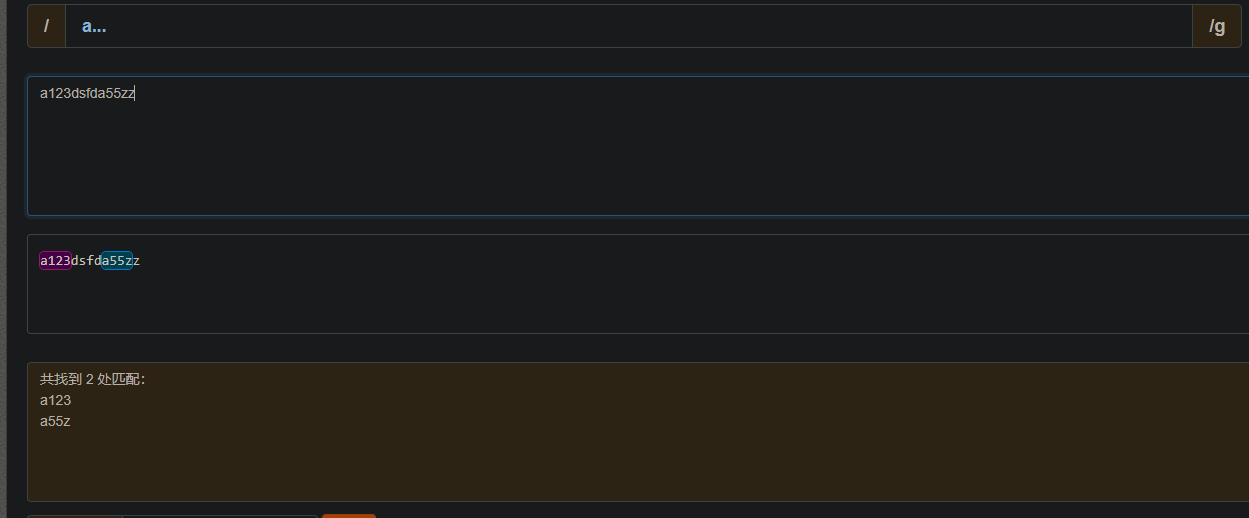
在上面的例子中,正则表达式是 /a.../,待匹配的字符串是 a123dsfda55zz,根据这个正则表达式的意思是,a 后面只要跟三个不是换行的字符即可,很显然 a123 和 a55z 都满足这个条件,所以就匹配到了这两处。
以上都是在匹配字符串中有什么,那我要匹配以什么什么开头或者以什么什么结尾的呢?正则表达式也可以做到,就是 ^ 和 $ 这两个特殊字符,^ 表示字符串开始位置,$ 表示字符串结尾位置,例如 /^abc/ 就是以 abc 开头的字符串,/abc$/ 则表示以 abc 结尾的字符串,如下所示:
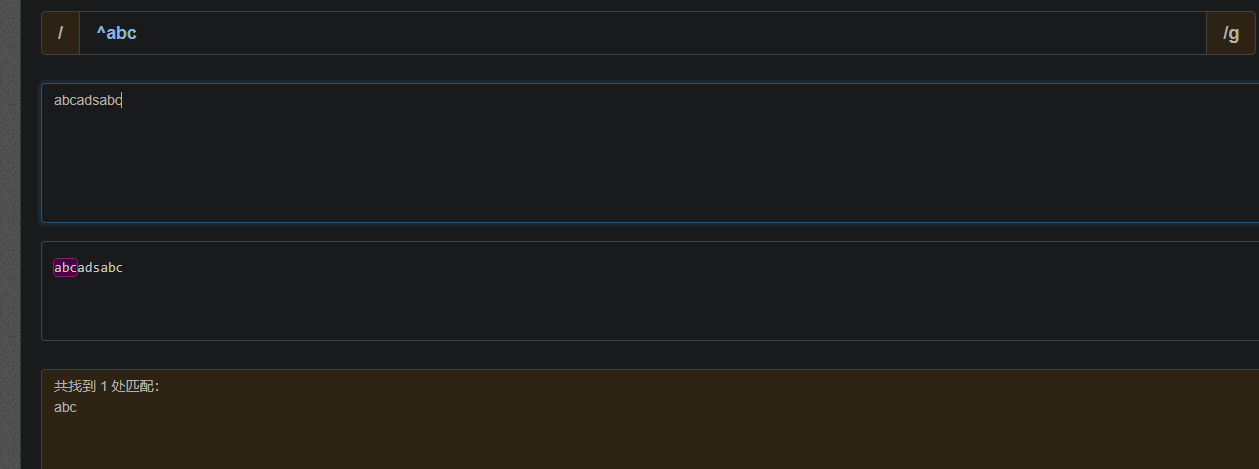
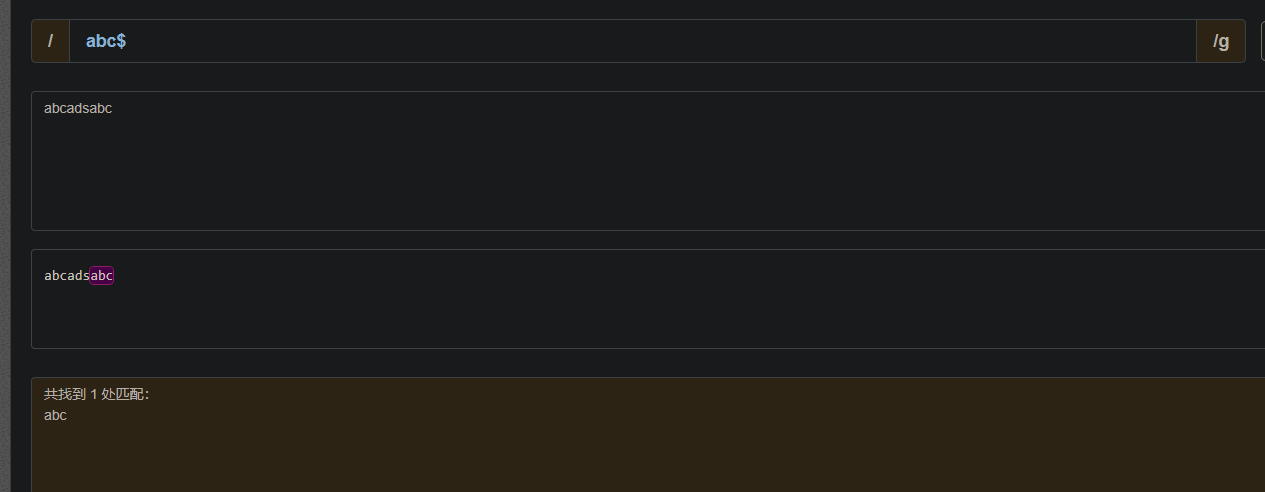
实际上,^ 就可以理解为字符串开头,$ 就可以理解为字符串结尾。/^abc/ 就可以理解为,字符串中包含 abc 这个字符串,并且 abc 字符串之前必须是字符串的开头,结尾也同理。
同理,对于 /^a.a/ 表示字符串的开始位置必须含有 a.a 这样的规则,比如 aza,aca 只要位于字符串首部,都可以满足规则。又比如 /^ab...c$/,可以看出,字符串长度必须是 6 位,并且前两位必须是 ab,最后一位必须是 c,例如 abbbbc,abcbcc 这些都可以被匹配到。
这里属于基础部分,只介绍这几个特殊字符。接下来看转义符,转义符和 JS 中的转义字符类似,先回顾 JS 字符串的转义字符,在字符串中,当我要在字符串中表示一个双引号的时候,除了模板字符串以及单引号字符串之外,还有一种方案就是转移字符,例如这样:"test\"test",在字符串中,由于双引号有特殊含义,所以这样就可以在双引号前面加上一个 \ 来消除这层特殊含义,又比如,n 本身在字符串中没有特殊含义,但我在前面加上了一个 \,变成了 \n,此时这个字符就表示换行,就变成一个有特殊含义的字符,这些其实就是转义字符。
在正则表达式中,转义字符如下表所示:
| 字符 | 描述 |
|---|---|
| \cx | 匹配由x指明的控制字符。例如, \cM 匹配一个 Control-M 或回车符。x 的值必须为 A-Z 或 a-z 之一。否则,将 c 视为一个原义的 'c' 字符。 |
| \f | 匹配一个换页符。等价于 \x0c 和 \cL。 |
| \n | 匹配一个换行符。等价于 \x0a 和 \cJ。 |
| \r | 匹配一个回车符。等价于 \x0d 和 \cM。 |
| \s | 匹配任何空白字符,包括空格、制表符、换页符等等。等价于 [ \f\n\r\t\v]。注意 Unicode 正则表达式会匹配全角空格符。 |
| \S | 匹配任何非空白字符。等价于 [^ \f\n\r\t\v]。 |
| \t | 匹配一个制表符。等价于 \x09 和 \cI。 |
| \v | 匹配一个垂直制表符。等价于 \x0b 和 \cK。 |
| \b | 匹配一个单词边界,即字与空格间的位置。 |
| \B | 非单词边界匹配。 |
| \d | 任意数字 |
| \w | 数字,字母,下划线 |
实际上,正则中的转义字符和 JS 中的转义字符类似。例如,我要匹配 \,就必须写 /\\/,因为 \ 本身就表示转义,是一个具有特殊含义的字符,所以就必须在前面加上一个 \,用两个反斜杠来表示一个反斜杠。又比如,在前面我们介绍了 . 是一个特殊字符,用于表示除了换行以外的所有字符,那如果我匹配的内容就是 .,就需要使用 /\./ ,即在前面加上 \ 的方式将 . 的特殊含义消除掉。
现在我有这样一个需求,第一位是 a,第三位是 d,第二位则是 b 或者 c 都可以,要实现这个需求,就需要用到字符集。所谓字符集,说白了还是一个字符,但是这个字符有多种情况,就像前面那个例子一样,有可能是 b,也有可能是 c,这就是字符集。字符集使用中括号来表示,字符集中的所有字符是一个或者的关系。比如前面的例子,我就可以使用 /a[bc]d/ 来实现,此时这个正则表达式可以匹配 abd 和 acd。可以看到,中括号表示的字符集本质上还是一个字符,中括号里面的很多字符是或者的关系。字符集内部还存在一些缩写,例如 /1[a-z]2/,这个正则表达式可以匹配第一位为 1,第三位为 2,第二位为 a 到 z 的任意一个字符。但这里是区分大小写的,如果我们要匹配小写的同时匹配大写,就这么写:/1[a-zA-Z]2/,同样,数字也可以写 0-9,实际上,/[0-9]/ 等价于 /\d/
字符集前面可以加上
^,表示非。即[^0-9]表示匹配除了数字以外的所有字符。很显然,^这个符号放在字符集内部和字符集外部所表示的含义是不同的,这个细节要注意。
实际上,这里的
a-z,表示的是字符编码在 a 到 z 之间的所有字符,所以我们可以通过 unicode 编码来进行匹配,例如我要匹配所有中文,就可以找到中文字符的 unicode 编码范围,经过查询为4E00-9FA5,所以我们就可以使用/[\u4e00-\u9fa5]/的方式匹配一个汉字。
以上的规则已经足够适应大部分场景了,这里考虑一个场景,我需要匹配 10 个数字,我们当然知道,[0-9] 就可以用于匹配一个数字,所以我们要匹配 10 个数字,当然可以写成 /[0-9][0-9][0-9][0-9][0-9][0-9][0-9][0-9][0-9][0-9]/,当然,如果我们要求的是只有 10 个数字,那就应该写成 /^[0-9][0-9][0-9][0-9][0-9][0-9][0-9][0-9][0-9][0-9]$/。显然这是很低效的做法,为了解决这个问题,就引入量词。
首先,如果要实现匹配 10 个数字的操作,我们可以使用 [0-9]{10} 这样,就可以匹配 10 个数字,那如果我要匹配 10 个到 15 个数字,就可以使用 [0-9]{10,15},如果我们要匹配 10 个以上的任意多个数字,也就是说至少 10 个数字,上不封顶,即使用 [0-9]{10,} 这种方式。
o{1,}等价于o+。o{0,}则等价于o*,o{0,1}等价于o?。即0+表示 0 这个数字出现一次或多次,而0*表示 0 这个字符出现 0 次或多次。
举个例子,我要匹配 11 位数字,且第一位数字必须非 0,就可以使用 /[1-9][0-9]{10}/ 这种方式。这里考虑更加真实的场景,设置密码,我要求密码只能是数字和字母,并且只能以字母开头,并且位数限制在 8 到 16 位,就可以这么来写:/[A-Za-z][A-Za-z0-9]{7-15}/ 即可。
量词这有一个细节,
/[0-9][a-z]{3}/表示的是第一位是数字,后三位是字母,即形如1abc这种。如果我要匹配形如1a2b3c这种,一个数字一个字母重复出现三次,这种情况需要添加括号,即(/[0-9][a-z]){3}/
接下来是逻辑相关,我现在要求匹配 123 或者 abc,就可以写成 /123|abc/,即 | 表示或者。
JS 中使用正则表达式
在 JS 中,正则表达式是 RegExp 这个构造函数创造的对象。我们可以直接写,只要一个值是被两个斜杠 / 包裹起来的,也可以通过构造函数创建,如下所示:
js
var reg = /test/;
var reg2 = new RegExp("test");
除此之外,还可以直接调用构造函数来创建一个正则表达式对象,但是直接调用构造函数产生的对象会存在一些区别。
js
var reg = /test/;
var reg2 = new RegExp(reg);
var reg3 = RegExp(reg);
console.log(reg === reg2,reg === reg3);//false true
显然,如果我们要基于一个正则表达式创建一个一模一样的正则表达式,则需要使用 new RegExp 这种方式,而直接调用构造函数这种方式,会将对象的地址原封不动返回回来。
在创造正则表达式的时候,可以添加一些配置,称为 flag,这里介绍三个
- g: 全局搜索,找到所有匹配项,如果没有这个配置,则在第一个匹配后停止
- i: 忽略大小写
- m: 多行匹配,主要针对
^和$,默认情况下这俩只能匹配字符串的开始和结尾,如果有了这个配置,这两个东西就可以匹配每一行的开始和结束。
匹配项的书写位置,如果是字面量形式的,直接在后面书写,例如我既要全局搜索,又要忽略大小写,可以写成:var reg = /test/gi,对于 new 关键字形式创建的对象,写在第二个参数,即 var reg = new RegExp("test","gi")
可以使用
RegExp.prototype.global属性判断是否开启了全局匹配,可以通过RegExp.prototype.ignoreCase属性判断是否开启了忽略大小写,可以通过RegExp.prototype.multiline属性判断是否开启了多行匹配,需要注意,这些属性均为只读属性,无法修改。
此时,正则表达式就可以分为两部分,分别是规则和配置,规则就是两个 / 包裹起来的部分,而配置就是第二个 / 后面的东西。我们可以通过 RegExp.prototype.source 来获得规则字符串。
接下来介绍两个重要的方法,第一个是 RegExp.prototype.test() 方法,这个方法非常有用,该方法返回一个布尔值,用于验证某个字符串是否满足规则。
js
var reg = /^a.c$/;
console.log(reg.test("abc"));//true
console.log(reg.test("acc"));//true
console.log(reg.test("abcc"));//false
值得注意的是,对于全局匹配,test 函数有一些值得注意的细节。
js
var reg = /abc/g;
var str = "123abc123abc123";
console.log(reg.test(str));//true
console.log(reg.test(str));//true
console.log(reg.test(str));//false
console.log(reg.test(str));//true
console.log(reg.test(str));//true
这个行为很诡异,明明是一样的代码,最后却输出了一个 false。实际上,如果开启了全局匹配,那么正则表达式会维护一个属性,我们称为 lastIndex,这个属性记录下一次匹配的起始索引,什么意思呢,也就是说如果正则表达式开启了全局匹配,就不一定要从字符串开始的位置进行匹配了,我们可以修改这个属性实现从字符串的指定位置进行匹配。
js
var reg = /abc/g;
var str = "abc123";
reg.lastIndex = 2; //从下标为2开始匹配
console.log(reg.test(str)); //false
可见,我修改了从下标为 2 的位置进行匹配,所以哪怕原字符串中有 abc,也无法进行匹配
lastIndex这个属性只有开启了全局匹配的情况下才会生效,不开启全局匹配是强制从最开始进行匹配的。
而 RegExp.prototype.test() 属性在作用于全局匹配的过程中会修改这个属性。还是以前面的例子为例,当执行完第一次匹配的时候,匹配到了下标为 3,4,5 的字符,lastIndex 属性的值变成了 6,表示下一次应该从下标为 6 的字符开始。这个属性是放在该对象上的,所以下一次进行匹配的时候依旧会带上这个属性,也就是依旧会从下标为 6 的位置开始进行匹配,直到匹配到字符串末尾,才会复位到 0,所以才会出现这么诡异的情况。按照这个规则来分析,第二次匹配从下标为 6 的地方开始,匹配到 9,10,11 三个字符,然后在下一次匹配就从下标为 12 的位置开始了,而下标为 12 的位置后面并没有可以匹配的字符了,所以就会输出 false,并且 lastIndex 复位为 0。
我们可以通过下面的代码验证:
js
var reg = /abc/g;
var str = "123abc123abc123";
console.log(reg.test(str), reg.lastIndex); //true 6
console.log(reg.test(str), reg.lastIndex); //true 12
console.log(reg.test(str), reg.lastIndex); //false 0
console.log(reg.test(str), reg.lastIndex); //true 6
console.log(reg.test(str), reg.lastIndex); //true 12
我们可以发现,由于改属性存在,所以我们在多次使用 test 函数的时候,会保留位置一直往后匹配,直到匹配不上才会返回 false,利用这个特性,我们可以实现一个效果,就是判断了匹配多少处
js
var reg;//这是一个开启了全局匹配的正则
var s;//这是一个字符串
var n = 0;
while(reg.test(s)){
	n++;
}
console.log(n);//输出匹配了多少处
贪婪匹配
正则表达式使用贪婪匹配模式,所谓贪婪匹配模式,就是尽可能多的去匹配,我们看下面的例子:
js
var reg = /[0-9]+/g;//匹配1次或多次,开启全局匹配
var str = "12345abc123";
console.log(reg.test(str),reg.lastIndex);//true 5
在上面的例子中,匹配 1 次或多次数字,但是这里存在问题,在字符串中,1, 12, 123, 1234, 12345 都可以被 /[0-9]+/ 匹配上,这里就会存在歧义,如果匹配的是 1,那么 reg.lastIndex 的值就应该是 2,表示下一次应该从 2 的位置开始匹配,如果匹配的是 12345,那么改属性的值就是 5。
正则表达式默认情况下使用贪婪匹配模式,即尽可能多去匹配,所以匹配到的结果就是 12345,而 reg.lastIndex 的值就是 5。
这个模式是可以修改的,如果在量词后面加上一个问号,就可以修改为非贪婪模式
js
var reg = /[0-9]+?/g;//匹配 1 次或多次,开启全局匹配,使用非贪婪模式
var str = "12345abc123";
console.log (reg.test (str), reg. lastIndex);//true 1
此时启用了非贪婪模式,所以 reg.lastIndex 的值就是 1,即本次只匹配到了 1
test 函数只能用于判断是否可以匹配上,而如果我们要拿到更详细的匹配信息,可以使用 RegExp.prototype.exec() 函数。
js
var reg = /abc/g;
var str = "123abc123abc123";
console.log(reg.exec(str)); //true 6
console.log(reg.exec(str)); //true 12
console.log(reg.exec(str)); //false 0
console.log(reg.exec(str)); //true 6
console.log(reg.exec(str)); //true 12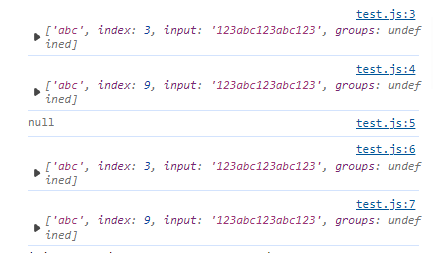
可以看到,第三次匹配还是无法匹配,所以不管是 test 还是 exec 函数,只要开启了全局匹配,都会启用这个 lastIndex 属性,所以其实我们可以认为,启用 lastIndex 是全局匹配的功劳,而不是某一个函数的作用。显然,exec() 方法会返回一个数组,这个数组里包含了匹配的详细信息,包括匹配到的字符串,原始字符串,匹配字符串的开始下标等等。
这个返回值是一个真数组,并不是伪数组,只是在真数组里加了一些属性。
这个 exec 方法已经可以完成所有的字符串匹配操作了,比如我们可以结合字符串中的 String.prototype.splice() 方法实现替换操作,但是自己写太麻烦了,所以在 String 类中提供了一些方法可以使用正则表达式来完成一些功能。
在前面,我们使用的是一个正则表达式去匹配字符串,我们也可以反过来,使用一个字符串去验证正则,这里使用的是 String.prototype.match() 方法
js
var reg = /abc/g;
var str = "123abc123abc";
console.log(str.match(reg));//['abc', 'abc']
很显然,match 只返回匹配到的字符串,可以获取匹配到的字符串以及匹配了多少次,但并没有正则表达式中的 exec 那么详细。
当然,这是开启全局匹配的情况下,如果关闭全局匹配,该函数基本等同于 RegExp.prototype.exec()。
js
var reg = /abc/;
var str = "123abc123abc";
console.log(str.match(reg));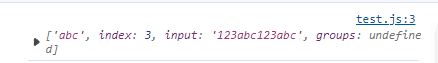
可以看到,在非全局匹配的情况下,基本等同于 exec() 方法,但是全局匹配的情况下得到的信息却比较少,但有时候我就是要在全局匹配的情况下,获取到第一次匹配的下标,就使用 String.prototype.search() 方法
js
var reg = /abc/g;
var str = "123abc123abc";
console.log(str.search(reg)); //3
可以看到,该方法可以返回第一次成功匹配到的下标。
该方法由于是 String 下面的方法,而
lastIndex是 RegExp 下面的属性,所以并不会受到其影响,即不管匹配多少次,都是从 0 的位置开始的。
而对于前面介绍的 String.prototype.split 方法而言,即按照指定字符分割字符串,将字符串分割为一个数组,该方法接受的参数除了字符串以外,还可以接受一个正则表达式,按照指定正则表达式匹配到的字符串分割字符。
js
var str = "abc abc-abc,abc";
//此时我要按照空格,短横线,逗号都作为分隔符,最后的结果应该是[abc,abc,abc,abc]
console.log(str.split(/[ \-,]/));//['abc', 'abc', 'abc', 'abc']
同时,
String.prototype.split方法可以传入第二个参数,即分割的最大数量,可以限定得到的最大数组长度,可以确保得到的数组不会超过指定长度。
最后是一个最重要的方法,String.prototype.replace(),这个方法可以用于替换字符串。
js
var str = "abc abc-abc,abc";
var newStr = str.replace("abc", "bcd"); //将第一个abc替换成bcd
console.log(newStr);//bcd abc-abc,abc
很显然,如果只传入一个字符串,那么只会匹配一次,这是由于这个函数的第一个参数应该是一个正则表达式,这里我们传入的是字符串,就会自动转换为正则表达式,而正则表达式 /abc/ 并不是全局匹配,所以只会匹配一次,也就只把第一个进行了替换。
replace 函数并不会改变原始字符串
如果我们要将所有的全部替换,就应该使用全局匹配,如下所示:
js
var str = "abc abc-abc,abc";
var newStr = str.replace(/abc/g, "bcd"); //将所有abc替换成bcd
console.log(newStr);//bcd bcd-bcd,bcd
这个方法的第二个参数是可以传入一个回调函数的,该回调函数会接受很多参数,第一个参数为匹配到的字符串,该函数返回值为替换的内容,有了这个之后,我们再要实现单词首字母大写,就是一个很简单的事情
js
var str = "this is a string";
var newStr = str.replace(/\b[a-z]/g,function (match){
	return match.toUpperCase();//将他变大写返回
});
console.log(newStr);//This Is A String
正则表达式进阶
正则表达式中,用小括号包裹的部分我们称为捕获组,捕获组会出现在匹配结果中。
js
var reg = /(\d[a-z])[a-z]+/g;//这里的(\d[a-z])就是捕获组
var s = "2aa34dklgjkla4klj";
while(result = reg.exec(s)){
	console.log(result);
}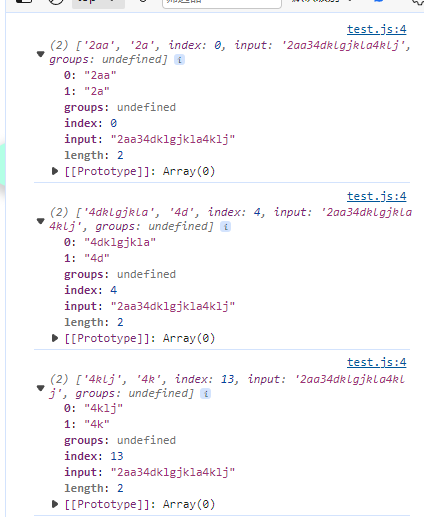
可以看到,此时每次执行 exec 函数,数组里就有了两项,第一项为真实的匹配结果,第二项为匹配结果中的捕获组。
举个实际例子,我要匹配一个年月日信息,格式为 2024-04-07,使用正则很好写,就是 /\d{4}-\d{2}-\d{2}/
js
var reg = /\d{4}-\d{2}-\d{2}/g;
var str = `2024-04-07,2024-02-01,2019-08-07`;
var result;
while(result = reg.exec(str)){
	console.log(result);
}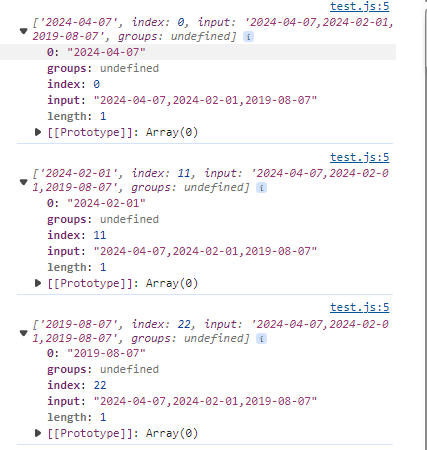
此时就会匹配到所有的日期。但是这个时候我有一个需求,就是要把年月日单独拿出来处理,我们当然可以使用字符串的 split 方法来按照 - 分割为数组,但是这样比较麻烦,我们可以使用捕获组。
js
var reg = /(\d{4})-(\d{2})-(\d{2})/g;
var str = `2024-04-07,2024-02-01,2019-08-07`;
var result;
while(result = reg.exec(str)){
	console.log(result);
}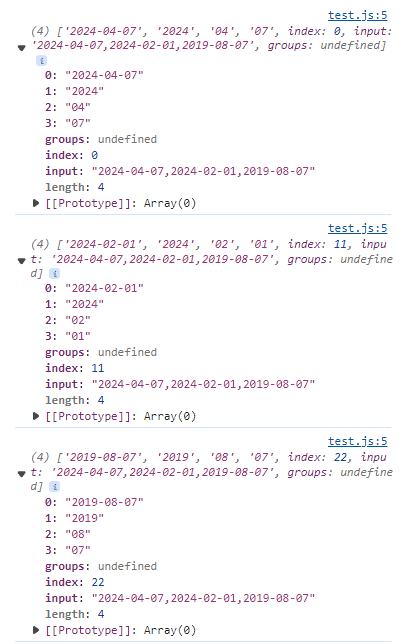
此时可以看到,我这里加了三个大括号,每次匹配就捕获三个东西,在 exec 函数中就可以获得每次匹配得到的捕获组。
捕获组的顺序是按照左括号,从左到右进行排列的。
捕获组是可以命名的,命名方式为在捕获组头部添加 ?<捕获组名>,如下
js
var reg = /(?<year>\d{4})-(?<month>\d{2})-(?<date>\d{2})/g;
var str = `2024-04-07,2024-02-01,2019-08-07`;
var result;
while(result = reg.exec(str)){
	console.log(result);
}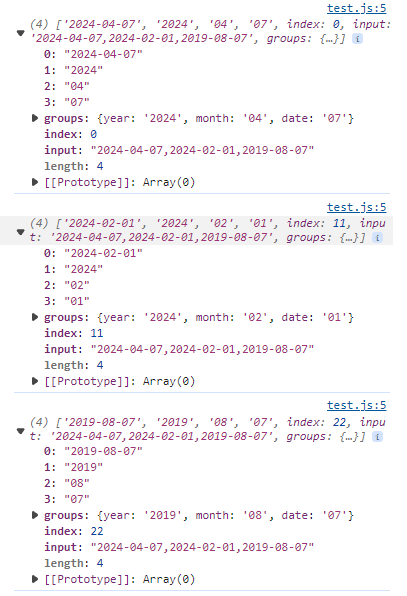
命名后的捕获组,可以在每次匹配得到的 groups 对象中得到。
命名后的捕获组成为具名捕获组
当然,我们有时候添加小括号并不是要把他当做一个捕获组,就是单纯想把它当做一个整体,这种情况下就可以用非捕获组,只要在左括号前面加上 ?:,即可将这个小括号理解为非捕获组
js
var reg = /(?:\d{4})-(?<month>\d{2})-(?<date>\d{2})/g;
var str = `2024-04-07,2024-02-01,2019-08-07`;
var result;
while(result = reg.exec(str)){
	console.log(result);
}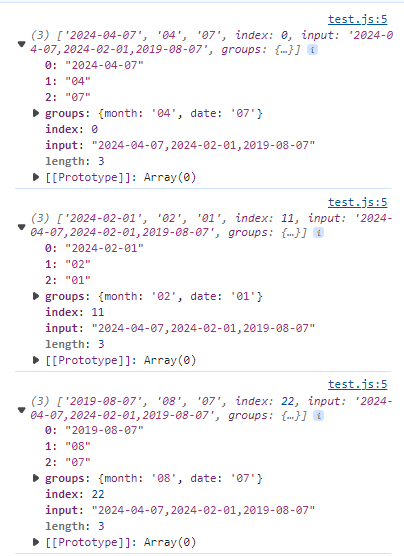
此时第一个年份的括号被变成了非捕获组,所以在匹配结果中就只捕获了后面两个括号。
除了在 exec 函数中可以使用捕获组,在 replace 函数中也可以使用捕获组。replace 函数的第一个参数为匹配到的字符串,后面的参数依次就是捕获组。
我们说过,replace 的第二个参数也可以是字符串,如果使用的字符串,也可以在字符串中使用捕获组,使用
$n可以拿到第 n 个捕获组
js
var reg = /(?<year>\d{4})-(?<month>\d{2})-(?<date>\d{2})/g;
var str = `2024-04-07,2024-02-01,2019-08-07`;
var newStr = str.replace(reg,function(match,a,b,c){
	//这里的a,b,c分别传入三个捕获组
	return `${a}/${b}/${c}`;
});
console.log(newStr);//2024/04/07,2024/02/01,2019/08/07

//以上方式等价于
var newStr = str.replace(reg,`$1/$2/$3`);
console.log(newStr);//2024/04/07,2024/02/01,2019/08/07
在正则表达式中,还可以使用捕获组,我们称这种使用为反向引用,书写格式为 \捕获组编号
js
var reg = /(\d{2})\1/g;//表示重复两个数字,并且引用这个捕获组,即把捕获的这两个数字重复一次
var str = "abc1122sss1212g1111d1234";
console.log(str.match(reg));//['1212', '1111']
如果捕获组有名字,可以使用名字来引用,如果要引用名字,使用
\k<捕获组名>的方式
接下来是预查,分为正向预查和反向预查。
我有这样一个需求,找到后面紧跟数字的字母,如果我要按照前面的知识,我只有把数字和字母都匹配出来,但是我要的是字母。这个时候就要使用预查。
js
var reg = /[a-zA-Z](?=[0-9])/g;
var str = "dfahsj342345jklk4h12jhkl5hl32lkhkl3";
console.log(str.match(reg));//['j', 'k', 'h', 'l', 'l', 'l']
很显然,如果使用正向预查,相当于在原有基础上,对后面的字符进行一个判断,这里我要匹配的是字母,但是我这里有一个条件,就是后面的字符必须要是数字,才是满足要求的字符,但这个判断条件本身只作为一个条件。
预查也得加括号,但是这里并不是捕获组
正向预查是判断是否满足,那么负向预查就是判断是否不满足。实际上就是相反的,负向预查的语法为:(?!规则)
js
var reg = /[a-zA-Z](?![0-9])/g;//后面不是数字的字母
var str = "dfahsj342345jklk4h12jhkl5hl32lkhkl3";
console.log(str.match(reg));//['d', 'f', 'a', 'h', 's', 'j', 'k', 'l', 'j', 'h', 'k', 'h', 'l', 'k', 'h', 'k']
注意,预查并不消耗字符
这里写一个真实需求判断密码强度
js
//我要求密码要包含数字,大写字母,小写字母,特殊符号,长度在8-16位
var password = "LLll11234.dff";
var reg = /^(?=.*[a-z])(?=.*\d)(?=.*[!@#_,.]).{8-16}$/;
//这里可以好好理解一下预查不消耗字符是什么意思了。前面几个预查都是从最开始的位置查的,如果有一个查询不成功,一定匹配不到,而后面的`.{8-16}`,由于前面都是预查,不消耗字数,所以也是从最开始进行匹配的。
console.log(reg.test(password));